난방기가 방을 데웁니다. 그런데 데워진 방도 난방기를 멈춥니다.
보통 원인은 결과를 만든다고 생각합니다. 스위치를 켜면 히터가 작동하고, 히터가 방을 데우는 식입니다.
하지만 온도조절기가 있다면 이야기가 달라집니다. 방의 온도가 목표에 가까워질수록 난방기는 약해지거나 멈춥니다. 처음에는 난방기가 온도를 바꿨지만, 이제는 바뀐 온도가 난방기의 다음 행동을 바꿉니다.
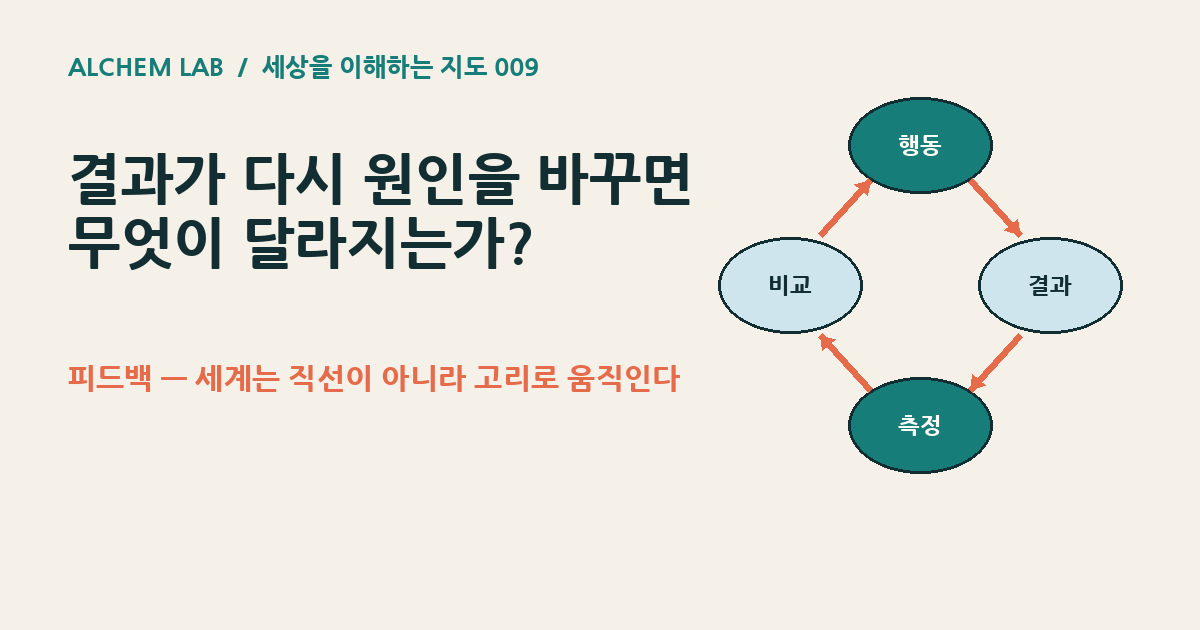
원인 → 결과에서 끝나지 않고, 원인 → 결과 → 측정 → 비교 → 다음 원인으로 고리가 닫힙니다. 이것이 피드백입니다.
왜 결과를 다시 봐야 할까요?
현실에는 예상하지 못한 변화가 계속 들어옵니다. 문이 열리고, 바깥 기온이 내려가고, 재료 상태가 바뀌며, 기계도 조금씩 마모됩니다.
미리 정한 명령만 반복하면 이런 변화를 스스로 바로잡기 어렵습니다. 실제 결과를 다시 봐야 행동이 부족했는지, 너무 강했는지, 방향이 틀렸는지 알 수 있습니다.
결과를 다음 행동에 직접 쓰지 않는 방식을 열린 고리, 결과를 측정해 입력을 다시 조정하는 방식을 닫힌 고리라고 합니다.
피드백 고리의 기본 구조
- 목표값 r: 원하는 상태, 예를 들면 23°C
- 출력 y: 실제 결과, 예를 들면 현재 19°C
- 오차 e = r − y: 목표와 실제의 차이
- 제어기와 구동기: 오차를 보고 실제 행동을 만드는 부분
- 센서: 결과를 측정해 고리 안으로 되돌리는 부분
센서 데이터가 있다는 사실만으로 폐루프가 되는 것은 아닙니다. 그 측정값이 실제로 다음 행동을 바꿔야 합니다.
음의 피드백과 양의 피드백
음의 피드백은 편차를 줄이는 방향으로 작용합니다. 방이 추우면 난방을 켜고, 더우면 줄이는 방식입니다. 여기서 ‘음’은 나쁘다는 뜻이 아니라 현재 편차와 반대 방향이라는 뜻입니다.
양의 피드백은 시작된 변화를 더 키웁니다. 분만에서는 자궁경부의 자극이 옥시토신 분비를 늘리고, 강화된 수축이 다시 자극을 키웁니다. 이 고리는 출산이라는 종료 조건에서 끝납니다.
따라서 양의 피드백은 무조건 고장이 아닙니다. 빠른 전환이나 완료가 필요할 때는 기능이 됩니다. 다만 포화, 자원 고갈, 종료 조건 같은 제약이 없다면 폭주할 수 있습니다.
최소 수학: 너무 세게 고치면 왜 흔들릴까요?
현재 출력이 yt, 목표가 r, 반응의 세기가 k라고 해봅시다.
et = r − yt
yt+1 = yt + k(r − yt)
그러면 et+1 = (1 − k)et가 됩니다.
- 0 < k < 1: 같은 방향에서 오차가 점점 줄어듭니다.
- 1 < k < 2: 목표를 번갈아 지나치지만 흔들림은 줄어듭니다.
- k > 2: 이 단순 모델에서는 오차가 커지며 발산합니다.
음의 피드백도 반응이 너무 강하거나 늦으면 흔들릴 수 있다는 뜻입니다. 실제 시스템에는 관성, 센서 잡음, 통신 지연, 구동기 한계가 더해지므로 안정성 판단은 더 복잡합니다.
생명은 고정이 아니라 조절로 버팁니다
항상성은 모든 값을 한 숫자에 완벽히 고정한다는 뜻이 아닙니다. 체온과 체액 같은 내부 상태를 생존 가능한 범위 안에 유지하도록 계속 감지하고 조절한다는 뜻에 가깝습니다.
목표와 허용 범위도 상황, 활동, 시간, 호르몬 상태에 따라 달라질 수 있습니다. 생명은 멈춘 균형이 아니라 움직이며 유지되는 균형입니다.
제조 현장에서는 센서가 공정을 다시 바꿉니다
사출기 배럴 온도를 생각해봅시다. 히터를 켠 시간만 정하면 재료 투입량과 주변 온도가 달라질 때 실제 온도도 달라집니다.
센서로 실제 온도를 읽고 목표와 비교해 히터 출력을 조절하면 폐루프가 됩니다. 그러나 센서가 느리거나 잘못 보정되면 제어기는 틀린 세계를 보고 행동합니다. 통신이 늦으면 이미 지나간 상태를 보고 과잉 보정할 수도 있습니다.
좋은 폐루프에는 빠른 제어기만이 아니라 정확한 센서, 신뢰할 수 있는 시간축, 지연 관리, 안전 한계, 수동 전환이 함께 필요합니다.
AI의 피드백은 같은 말일까요?
강화학습에서 에이전트는 행동의 결과와 보상을 받아 미래의 행동 규칙을 바꿉니다. 그러나 보상은 제어공학의 오차와 같은 개념은 아닙니다.
제어 피드백은 지금의 출력과 목표 차이를 줄이기 위해 빠르게 행동을 조정합니다. 학습 피드백은 경험을 이용해 더 긴 시간 동안 정책이나 모델 자체를 바꿉니다. 현실의 로봇은 안쪽의 빠른 제어 고리와 바깥쪽의 느린 학습 고리를 함께 가질 수 있습니다.
위계 다음에 피드백이 오는 이유
008편에서는 많은 부분으로 이루어진 전체가 다음 수준에서는 하나의 대상이 된다고 보았습니다. 이제 그 수준 사이를 정보와 명령이 왕복합니다.
센서 → 부품 상태 → 설비 상태 → 라인 판단으로 정보가 올라가고, 상위 목표 → 작업지시 → 설비 동작으로 다시 내려옵니다. 서로 다른 시간척도의 고리가 겹치면 세계는 직선 인과관계가 아니라 동적인 순환망으로 보이기 시작합니다.
오늘의 핵심
- 피드백은 결과를 다시 측정해 다음 행동을 바꾸는 순환 구조입니다.
- 음의 피드백은 편차를 줄이고, 양의 피드백은 편차를 키우는 방향입니다.
- 안정성은 부호만이 아니라 이득, 지연, 센서, 구동기, 제약의 결합으로 결정됩니다.
- 생명·공학·제조·AI에는 서로 다른 목적과 시간척도의 피드백 고리가 있습니다.
다음 010편에서는 대상부터 피드백까지의 개념을 한 장의 전체 세계 모델로 처음 조립합니다.


